 Редакция Потока
Модель учится на ответах другой модели. Когда это помогает, а когда обедняет данные
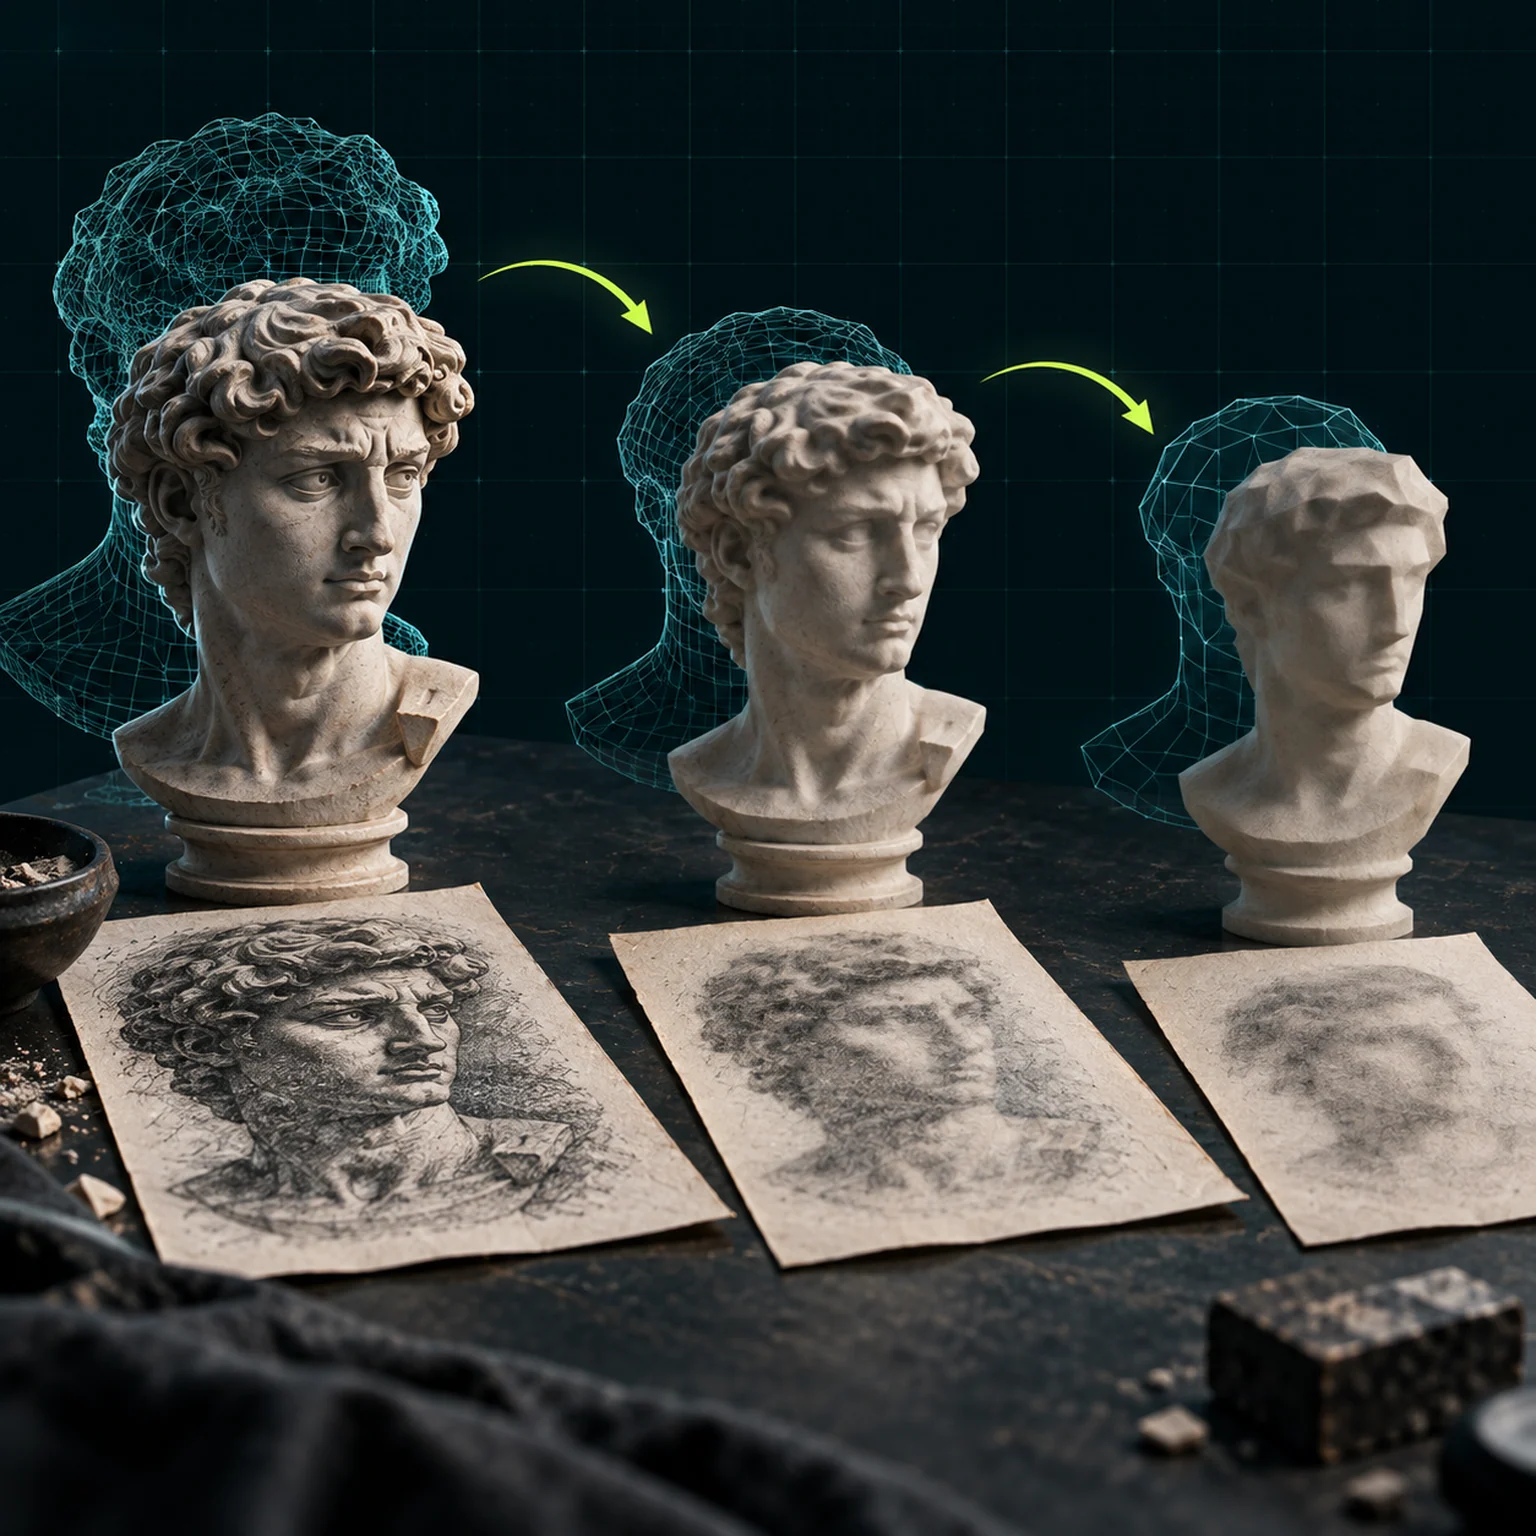
Если снова и снова пересказывать один пересказ, необычные детали постепенно исчезают. Похожая проблема возможна при обучении ИИ на сгенерированных данных. Но вывод «любой синтетический текст портит модель» слишком широк.
Внедрим ИИ в работу вашей компании
Бесплатно разберём процессы и подготовим план запуска ИИ.
Что исследователи называют коллапсом
В работе Nature о model collapse исследователи рассматривают повторное обучение поколений моделей на данных, созданных предыдущими моделями. В изученных условиях редкие части исходного распределения могут теряться, а ошибки накапливаться. Работа описывает определённые режимы обучения; она не доказывает, что любой набор с участием ИИ неизбежно приводит к одному результату.
Для понимания представим набор обращений в поддержку. Большинство клиентов спрашивают о доставке. Редко встречаются случаи с частичным возвратом, несколькими получателями и потерянной этикеткой. Генератор может охотно воспроизводить частые сюжеты и постепенно сгладить редкие сочетания.
Почему аккуратный набор может стать беднее
После генерации тексты выглядят ровнее: одинаковая длина, понятные формулировки, меньше опечаток. Но реальный пользователь пишет обрывками, путает название услуги и меняет условие в середине сообщения. Если убрать всю эту сложность, модель будет тренироваться в более удобном мире, чем тот, где ей предстоит работать.
Опасность состоит не только в неверных фактах. Можно получить тысячу правильных примеров, которые почти повторяют друг друга. Размер набора вырастет, а разнообразие задач — нет.
Как использовать генерацию осмысленно
Синтетические примеры полезно создавать под конкретный пробел: например, добавить варианты неоднозначного запроса. Отправной точкой служит описание случая и проверяемый ожидаемый ответ. Сам факт генерации не заменяет проверку разметки.
| Проверка набора | Что она помогает заметить |
|---|---|
| Происхождение каждого примера | Где реальные данные, где генерация, где ручная правка. |
| Разнообразие сценариев | Не заполнила ли одна простая тема почти весь набор. |
| Редкие случаи | Сохранились ли исключения, ошибки ввода и сложные сочетания. |
| Независимая проверочная выборка | Работает ли улучшение на данных вне процесса генерации. |
Небольшой опыт до большого обучения
Возьмите несколько десятков обезличенных задач, которые отражают реальные трудности вашей системы. Составьте карту сценариев. Затем добавьте синтетические варианты лишь в выбранные пробелы и попросите специалиста проверить ответы.
Сравнивайте версии модели на отдельном наборе, который не использовался ни для генерации, ни для настройки. Если средняя оценка выросла, но редкие обращения стали решаться хуже, не скрывайте это за одним числом. Для службы поддержки именно такие случаи могут быть самыми дорогими.
Редакционная рекомендация проста: учитывать происхождение и разнообразие данных. Генерация расширяет возможности подготовки примеров, когда понятно, какую нехватку она восполняет и кто проверяет результат.
О материале и источниках
Материал подготовлен редакцией Потока с участием ИИ. Источники проверены 12 сентября 2026 года. Учебные ситуации и запросы придуманы редакцией; собственные испытания продуктов не проводились. Иллюстрация объясняет идею и не является фотографией события или снимком интерфейса.
- Nature: AI models collapse when trained on recursively generated data
Первичное исследование рекурсивного обучения; выводы ограничены изученными условиями.
- Nature: исправление к статье
Исправление обозначения в формуле; учтено при работе с источником.
Опубликовано